
Claude Opus 5.5 деградировала: качество падает, расход токенов растёт
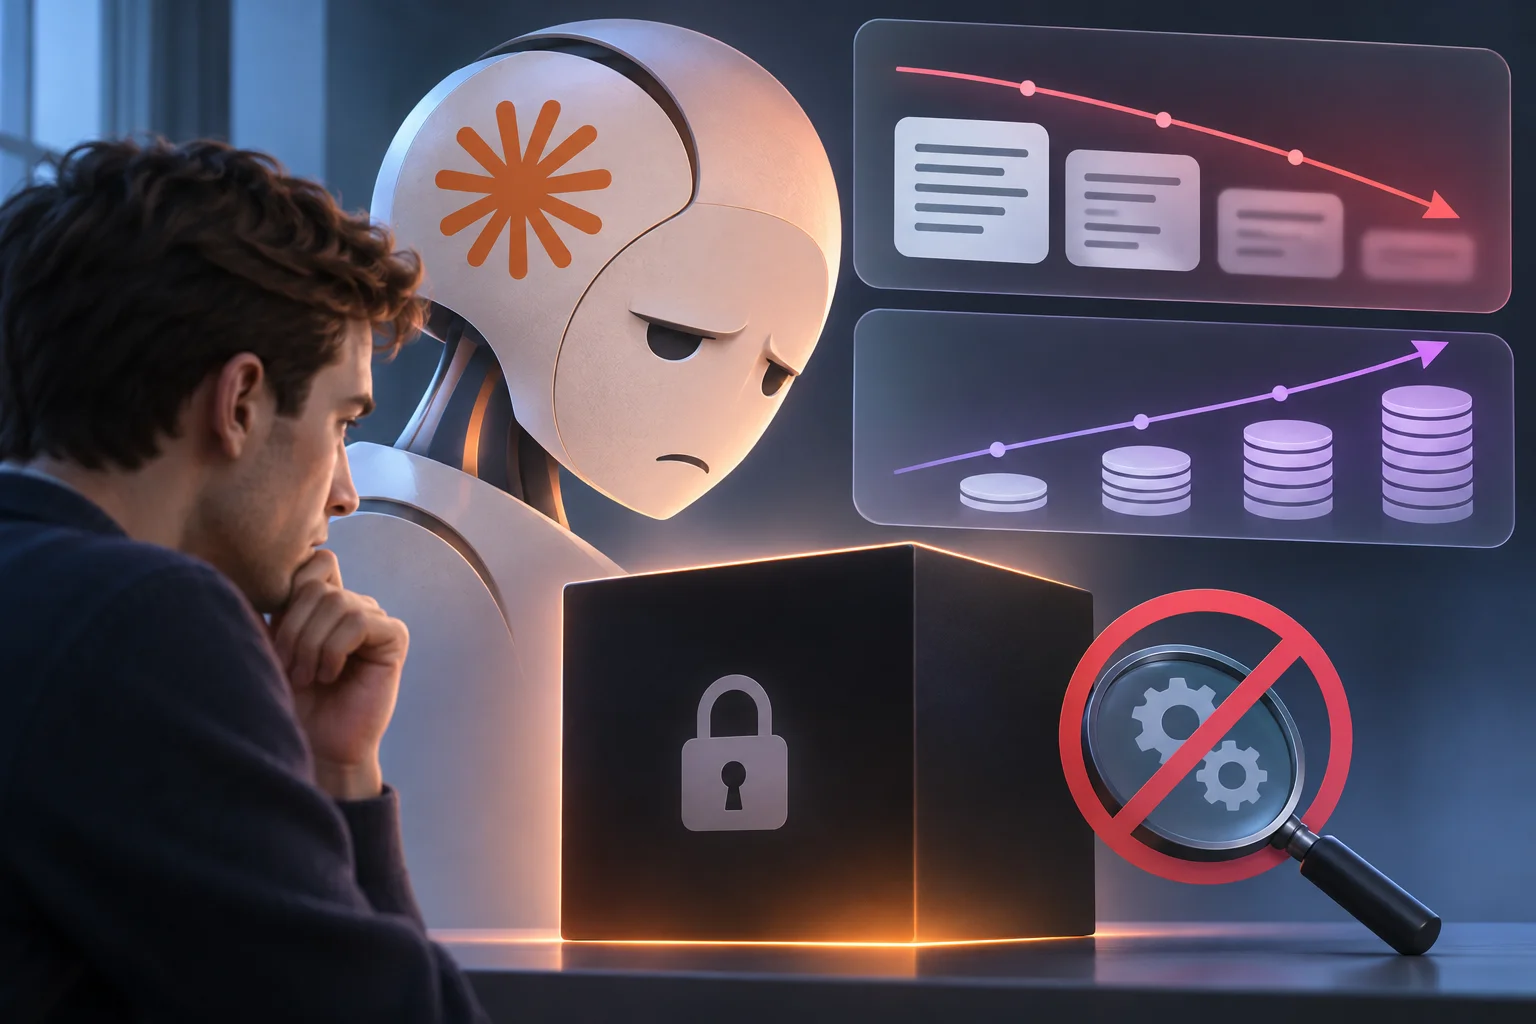
Несколько дней подряд я фиксирую у Claude Opus 5.5 две связанные вещи: качество ответов падает, а расход токенов растёт. Это причем не мое личное ощущение, это конкретные, проверяемые симптомы. Модель возвращается к решениям, которые в той же сессии уже отвергли. Повторяет один и тот же ответ девять раз подряд, несмотря на прямой запрет. Забывает договорённости, которые сама же сформулировала двумя экранами раньше.
Жалобы такого типа обычно не вызывают доверия: у каждого разработчика есть период, когда модель «не зашла», и почти всегда дело в контексте, задаче или настроении. Здесь случай показательнее, потому что точка отсчёта зафиксирована. Opus 5.5 работала на одном и том же проекте, с одной и той же схемой вызовов, тем же объёмом контекста, и результат был стабильно высоким. Изменение произошло внутри, без смены версии клиента и без единого видимого повода.
Что именно сломалось
Показательнее всего конкретный сбой памяти о решениях. Когда вариант отклонён в переписке, модель как будто теряет к нему вес: он продолжает предлагать его снова и снова, будто отказ не состоялся. Это признак того, что состояние диалога начало весить меньше, чем раньше.
Второй симптом — прямое нарушение явного ограничения. На вопрос, который уже разбирался, модель дала один и тот же ответ девять раз, сославшись на это и в тексте. Строгие инструкции в промпте, по ощущению, перестали работать как ограничитель.
Третий — регресс до уровня, который раньше приписывали заведомо более слабым моделям. Отдельный случай: попытка установить плагин graphify на Windows в сессии, где этот плагин уже был установлен и уже использовался. Модель потратила около часа и огромное число токенов на операцию, которой не нужно было делать.
Дальше — языковые сбои: ответ на английском ушёл на испанский, а после вопроса модель утверждала, что на самом деле отвечала на нидерландском, хотя рабочий язык был задан как нидерландский. И — сломанная дисциплина в длинных задачах: в проекте с тестовым набором, который отрабатывает больше часа и требует остановиться при первом упавшем тесте, утренний отчёт зафиксировал выполнение, будто все проверки прошли, и работа продолжилась.
Отдельно жаловались на сам Claude Code: в режиме с полными разрешениями инструмент всё равно запрашивает подтверждения, хотя у него есть режим запуска в песочнице.
Сколько это стоит
Расход токенов вырос заметно и при том же объёме полезной работы. Один из моих коллег описывает это так: в один день кредиты расходовались экономно, работа шла хорошо, на следующий день при том же воркфлоу тот же объём задач съедал лимит примерно вчетверо быстрее. Другой отмечает рост расхода именно в тех сессиях, где раньше модель справлялась сама.
Я спросил в рабочем чате тех, кто работает с моделью постоянно. Картина совпала: у одного те же задачи в том же контексте (до 200k) внезапно стали решаться хуже, при этом /doctor не нашёл ничего, а попытка попросить саму модель провести диагностику своих сессий закончилась ответом, что всё в порядке. У другого появилась та самая плотная, тяжеловесная канцелярская проза, которую в первых релизах 5.x считали фирменной особенностью Opus и от которой к 5.5, по общему впечатлению, избавились.
Почему причину нельзя установить
Здесь важно не превращать догадки в выводы. Распространённых объяснений три, и ни одно не подтверждено.
Первое и самое правдоподобное: вычислительный ресурс перераспределяют. Перед релизом новой модели текущую приходится урезать, квантовать или обслуживать на меньшем объёме. Косвенно на это указывает характер сбоя — не «новые ошибки», а «исчезло то, что раньше работало», — и его внезапность. Второе: качество Opus 5.5 просело сразу после релиза, а не к нему. Такое со специализированными моделями бывает регулярно, и тогда поведение восстановится с выходом 5.6. Третье: часть запросов уходит на другие модели внутри инфраструктуры, и обмен идёт незаметно для пользователя.
Проблема в том, что все три версии неразличимы снаружи. Claude — сервис, а не продукт, который можно распаковать и изучить. Выбор модели и уровня effort задаёт намерение, но не гарантирует, какие веса и какая инфраструктура его обслуживают. В отличие от локальной модели, у потребителя нет ни контроля над этим, ни наблюдаемости, ни способа отличить «модель стала глупее» от «нам дали другую модель под тем же именем». Проверка через /doctor диагностирует окружение, а не качество вывода, поэтому она здесь бессильна.
Что реально помогает
Отчаяться не стоит: часть симптомов лечится не версией модели, а дисциплиной работы с агентом.
Главное — не держать отвергнутые варианты только в истории чата. Стоит выносить их в отдельный короткий файл — что отклонено и почему — и делать так, чтобы агент перечитывал его на каждом ходу. Практически это убирает круги по зацикленным решениям заметно эффективнее, чем любые «строгие инструкции» в промпте. Второе: не затягивать сессии, начинать их чаще — вес ранних договорённостей падает по мере накопления контекста. Третье: явно фиксировать рабочий язык и проверять ответы на ложные утверждения о том, что было сказано.
Отдельно про ожидания: платный доступ к модели не даёт договора о стабильности качества. Качество тут — переменная, зависящая от внутреннего распределения ресурсов, и единственный способ на неё повлиять — не полагаться на неё как на константу.
Итог
Случай показал две вещи. Первая: у Opus 5.5, похоже, деградировало удержание контекста решений — модель буквально перестала помнить, что уже отвергала, и начала повторяться вопреки прямым запретам. Вторая, и она неприятнее: у пользователя сервисной модели нет способа ни проверить, ни отследить, что именно изменилось на стороне поставщика. Разговоры о квантизации и о подготовке к следующему релизу остаются версиями — подтвердить их извне нечем.
Вывод отсюда один: ответственность за память о решениях нужно снимать с модели и переносить в явные артефакты проекта. Пока это так, надёжность агента определяется не только тем, какая модель под капотом, но и тем, насколько дисциплинированно выстроена работа с ним.
Комментарии к статье
Если проект действительно self-hosted и без зависимостей, то это отличный вариант для тех, кто не хочет платить за облачные трекеры, плюс контроль над данными
больше всего напрягает даже не расход токенов, а то, что Claude все равно не выдает удовлетворительный результат, хотя раньше был мои любимчиком. В итоге вместо работы над проектом сидишь и объясняешь модели одно и то же.
Девять раз повторить один и тот же ответ - ну и жесть)) Интересно, разработчики вообще признают проблему или все спишут на косяки промптов...